Interview Agent
Interview Agent es una app de voz para practicar entrevistas de trabajo. Lee tu CV y la oferta, planifica la entrevista, la conduce contigo en voz alta en el navegador y después repasa tus respuestas una por una, señalando lo que dijiste.
De dónde sale
Lo construí después de una entrevista de trabajo en la que nunca hablé con una persona. Las preguntas las hacía un bot. Tardaba en responder, me interrumpía con facilidad y cortaba mis respuestas antes de que terminara.
Esa llamada se convirtió en una lista de requisitos. El entrevistador que yo quería espera a que de verdad termine, empieza a hablar en cuanto tiene algo que decir, recuerda lo que ya le conté y me juzga por lo que dije y no por lo fluido que soné. Todo lo demás en esta página sale de esa lista.
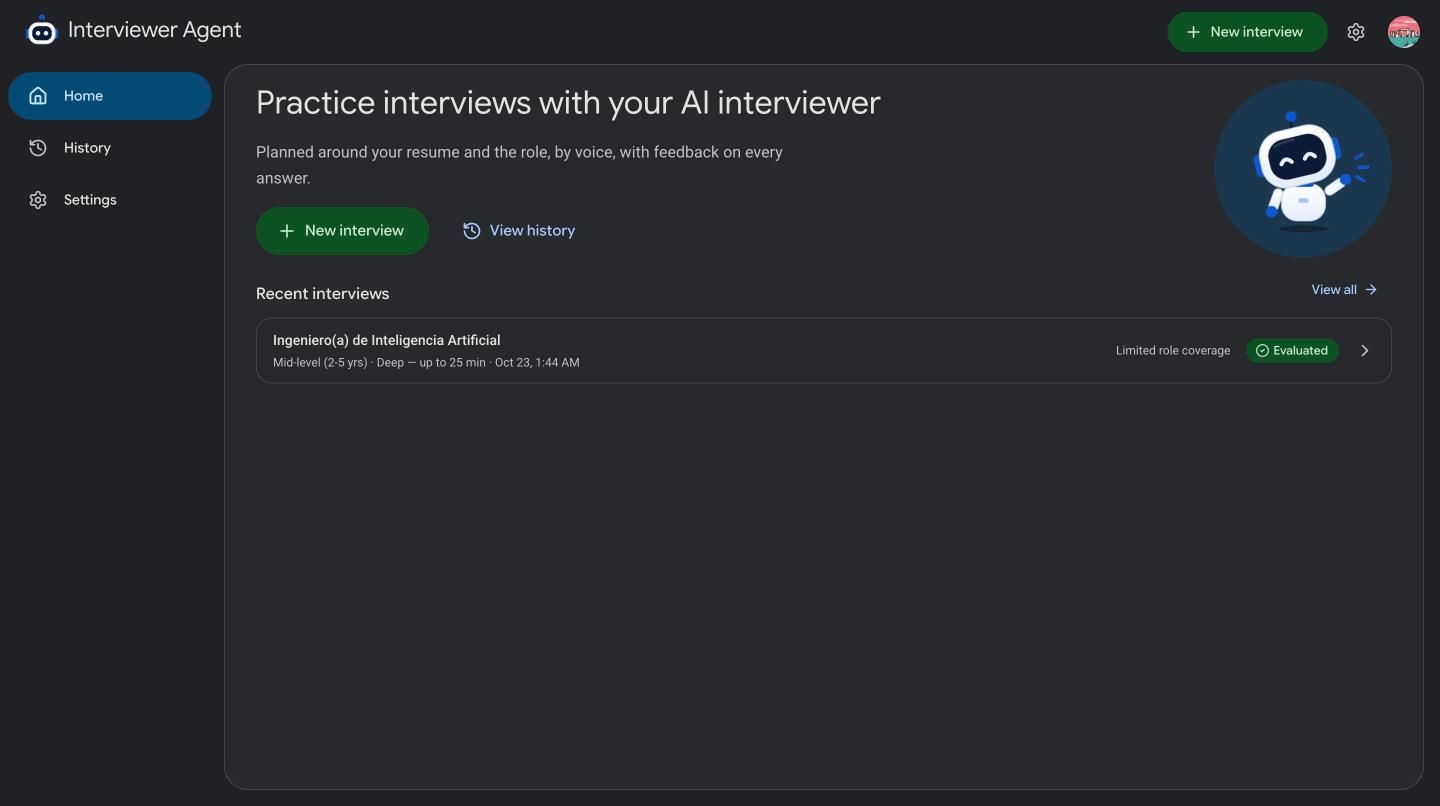
Cómo es una sesión
Subes tu CV en PDF y pegas la oferta. Cuatro pasos cortos después, el planificador tiene la sesión lista: el puesto pone el listón, el CV aporta los ejemplos y tú eliges el nivel, el idioma, la duración y si quieres preguntas técnicas, de comportamiento o mixtas.
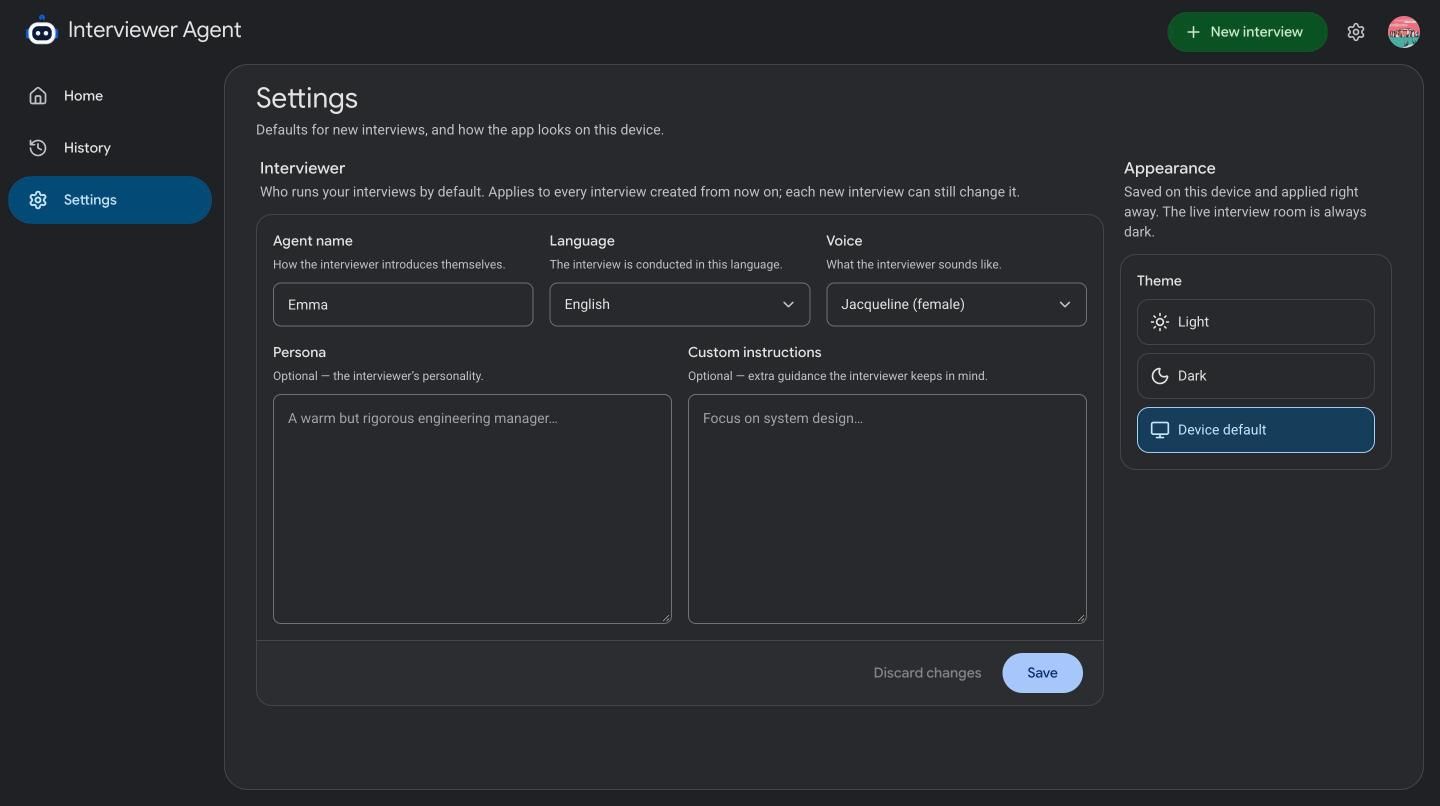
Una sala previa te deja probar el micrófono y la cámara, y después la entrevista ocurre por voz. El entrevistador te saluda por tu nombre, pregunta, escucha, repregunta cuando una respuesta queda vaga y avanza cuando un tema está cubierto. Funciona en inglés o en español, con una voz femenina o masculina por idioma, y con una personalidad e instrucciones fijas que defines una vez en Ajustes.
Al terminar, los resultados se abren en tres pestañas. El resumen dice cómo acabó la entrevista y si la sesión cubrió suficiente del puesto como para merecer un veredicto. Debajo, cada respuesta floja aparece junto a una versión más fuerte de la misma respuesta, construida solo con lo que de verdad dijiste. La pestaña de temas califica cada tema planificado con citas de la transcripción como evidencia, y la de transcripción guarda la conversación entera.
Repetir vuelve a correr el mismo puesto con preguntas planificadas de nuevo, y cada repetición queda agrupada bajo la original, así que el historial funciona como un registro de práctica y no como una pila de intentos.
Tres agentes, una entrevista
El trabajo se reparte entre tres agentes que se pasan el relevo. Comparten un mismo modelo de OpenAI y se diferencian en cuánto pueden pensar: poco el entrevistador, donde cada segundo de silencio cuenta, más el planificador y lo máximo el evaluador, que corre cuando nadie está esperando.
- Planificador. Extrae una rúbrica de la oferta y del nivel del puesto y luego personaliza los ejemplos con el CV sin bajar el listón. Cada tema apunta a un requisito, y los requisitos que tuvo que dejar fuera quedan listados en vez de desaparecer en silencio.
- Entrevistador. Un agente de voz en tiempo real construido sobre LiveKit Agents. El reconocimiento de voz, la síntesis y la detección de turno son sus oídos y su boca; un grafo de LangGraph es la parte que decide qué preguntar después, con el CV, la oferta y el plan completos en contexto. Cada decisión se valida y se escribe en la base de datos antes de que la pregunta se diga en voz alta.
- Evaluador. Corre solo cuando la sesión ha cerrado y la transcripción está sellada. Califica cada criterio con citas como evidencia, separa lo que se cubrió de lo que se demostró y se niega a dar una nota global o un veredicto cuando la sesión dejó fuera requisitos esenciales.
No hay base de datos vectorial. El CV extraído se guarda como texto y se entrega entero a los tres agentes: cabe en contexto, y un sistema de recuperación solo habría añadido un sitio más donde fallar.
Con qué lo construí
Un front end en React, una API en FastAPI y un worker de voz, alrededor de una sola base de datos PostgreSQL. Cada pieza corre en un servicio gestionado y se despliega sola desde la rama principal.
- La app web, compilada como SPA con componentes de shadcn/ui y servida desde Vercel. Las páginas de privacidad y términos se prerenderizan, así que se leen sin JavaScript ni inicio de sesión.
- La API: entrevistas, planes, evaluaciones, inicio de sesión y una ruta diaria de mantenimiento. Corre en FastAPI Cloud y baja a cero cuando está inactiva; la app web lo avisa mientras la primera petición la despierta.
- La tubería de audio: reconocimiento, síntesis y un modelo de detección de turno encima de la detección de actividad de voz. El navegador entra a la sala por WebRTC y el worker corre en LiveKit Cloud.
- El grafo de decisiones del entrevistador. Las decisiones validadas se confirman en una transacción antes de entregar la pregunta, así que una caída a mitad de turno nunca pierde ni repite una pregunta por accidente.
- Un modelo para los tres roles, con salidas estructuradas y reintentos para que el planificador y el evaluador corran sin supervisión.
- Texto del CV, planes, hitos, transcripciones e intentos de evaluación, con migraciones de Alembic. Neon la aloja y además provee el inicio de sesión con Google o GitHub a través de Neon Auth.
- Latencia, gasto y desenlaces de cierre van a Grafana como métricas anónimas; los errores, a Sentry. El trazado con LangSmith existe pero es opcional, porque recibiría el contenido completo de cada entrevista.
- Compose para el stack local, Terraform para Neon y Grafana, y un flujo que aplica las migraciones primero y luego despliega la API y el worker en paralelo.
- Pytest contra un contenedor de Postgres desechable, Vitest en el front end y un arnés de texto que corre el planificador, el entrevistador y el evaluador reales en la terminal para revisar el razonamiento sin micrófono.
Las decisiones difíciles
La mayor parte del tiempo se fue en lo que no sale en una captura.
Dejé de construir la fontanería de voz a mano. Una primera versión era dueña de todo el camino del audio: captura, reglas de silencio, mis propias heurísticas de turno. Me enseñó mucho y nunca iba a sonar humana. Ahora WebRTC y LiveKit se encargan del eco, las interrupciones y la reconexión, y el final de un turno lo decide un modelo entrenado para eso. Es justo la parte en la que falló el bot que me entrevistó. El coste es una dependencia alojada que no controlo; la ganancia, cada hora que fue a la entrevista en vez de a la fontanería.
Todo es estado persistido. Las respuestas tienen identidades estables y versiones de texto inmutables, así que una corrección nunca sobrescribe lo que se oyó primero. Una pregunta persistida que nunca empezó se reanuda con el mismo ID; una interrumpida no se repite sola, y «Escuchar de nuevo» reproduce la pregunta guardada sin una nueva decisión del modelo. Reconectarse conserva la hora de inicio original y el presupuesto ya gastado.
No se califica lo que no se oyó. Un audio perdido no es una respuesta incorrecta. La caída del worker, el abandono y las grabaciones incompletas quedan visibles como lo que son, y una sesión que saltó requisitos esenciales recibe feedback por criterio pero no una nota global. El evaluador lee una transcripción sellada, nunca el flujo de subtítulos en vivo.
El contenido se trata como sensible. Los CV y las ofertas tienen límites de tamaño y nunca se recortan en silencio. Los logs nunca contienen contenido de la entrevista, las entrevistas viejas se purgan según un calendario y el único servicio que puede ver una entrevista entera es uno que enciendes tú.
Lo que me llevo
- No reconstruir problemas resueltos. Mi propia tubería de audio me enseñó por qué WebRTC, la detección de actividad de voz y la detección de turno son una disciplina aparte, y que mis horas valían más en los agentes.
- Lo rápido que se siente vale más que lo listo que es. Darle al entrevistador el presupuesto de pensamiento más pequeño y convertir su respuesta en voz mientras se genera hizo más por la conversación que cualquier modelo más listo.
- Las salidas estructuradas convierten las llamadas al modelo en funciones. El planificador y el evaluador devuelven esquemas validados con reintentos, y eso es lo que permite que corran sin que nadie revise la salida antes de que llegue a la pantalla.
Lo sigo usando. La sesión de las capturas de arriba es una mía, hecha unos días antes de escribir esto.